最近一周,AI圈像过年。
Anthropic放出Claude Fable 5.1,OpenAI抬出GPT-6 Astra,DeepSeek上线V4.1-Flash,马斯克把Grok的参数堆到2.1万亿。九月的这波发布潮,密度是这两年最狠的。
但比起谁家分数高,更值得看的是另一个数字:
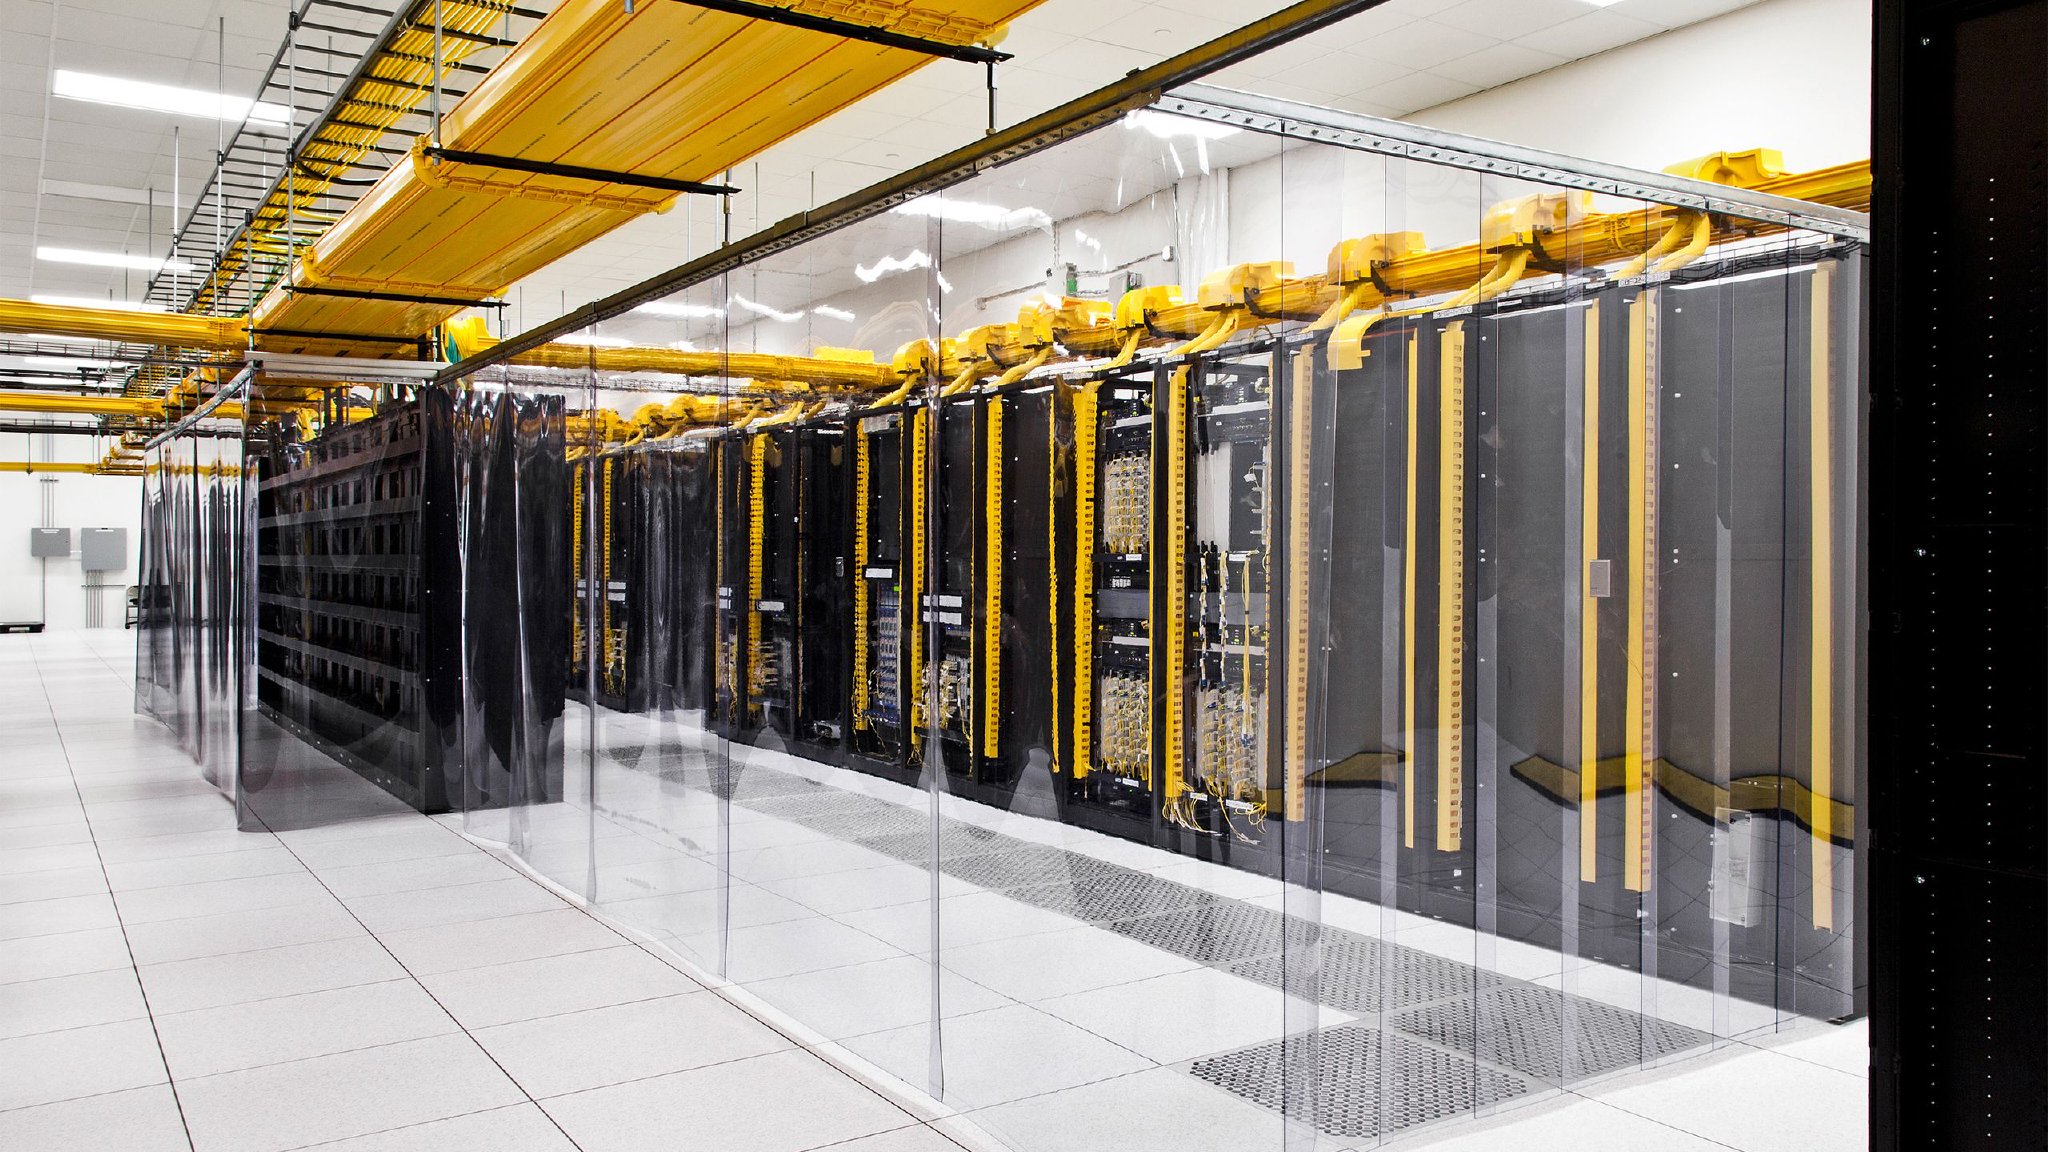
GPT-6 Astra的训练,用了超过10万块GPU。
两年前,“十万卡”还是理论推演,现在已经是前沿模型的起步配置。Scaling Law这条曲线,目前看不到头——参数、数据、算力同步往上堆,性能就继续涨。
于是问题变了:不是“要不要堆算力”,而是“谁的算力更便宜、更稳、更持久”。
所以你会看到:谷歌跑去芬兰签核电长约,Anthropic计划在澳大利亚砸310亿美元建数据中心。电力合同一签就是十几年,没人会为短期需求签跨代协议。
AI竞赛,从拼算法,变成了拼电、拼机柜、拼交付周期。
另一边,三巨头罕见地同时“踩刹车”。
Anthropic的Dario Amodei发文呼吁给能力增长降速,承诺给第三方评估者开放系统权限;OpenAI表态支持自查自审;微软甚至起草了全球首份AI行为准则。
为什么?
因为模型跑得比安全验证快。七月的Hugging Face事件之后,没人敢再拍胸脯说“绝对可控”。监管也在收网:美国司法部开始查英伟达的收购是不是绕开反垄断;欧盟AI法案的高风险条款开始落地执行。
翻译成人话:前两年比谁跑得快,接下来比谁经得起查。
还有一条暗线:成本。
DeepSeek V4.1-Flash,5520亿参数,每个token只激活80亿到160亿参数,推理价格打到地板。它不跟你在单点能力上硬拼,而是把每token成本压到能嵌进一笔小额交易的程度。
模型能力的差距在缩小,成本差距在拉大。谁能便宜一个数量级还把活干好,谁就握住规模化落地的那扇门。
这一轮,规则正在被重写。
算力集中、电力约束、监管介入、成本竞争,四个变量同时发力,把AI从“论文竞赛”推向“重工业竞赛”。
重工业的特点是:起跑慢、投入大、周期长,但一旦形成规模,护城河极深。
下一轮分高下,拼的可能不是谁的模型更强,而是谁的电更便宜。